
- 公開日
“文章を書かないAI”Jevから考える、企業AIの次の形
企業のAI活用というと、「全社員にChatGPTを配る」「Copilotを導入する」「社内版ChatGPTを作る」といった姿を想像することが多いと思います。
社員がAIと対話しながら、企画を考え、調べ、文章を書く。その価値はあります。ただ、社員が使うAIを整備することと、業務そのものにAIを組み込むことは、同じ設計課題ではありません。
チャット画面を開かなくても、問い合わせが適切な部署へ届き、確認が必要な申請は保留される。そんなAI活用もあるはずです。
そう考えるきっかけになったのが、Xで見かけたTypeSafe AIの「Jev」でした。
https://x.com/completeskeptic/status/2099925682726002904
発表には、大幅な高速化や低コスト化を示す数字が並んでいます。でも、私が気になったのはそこではありません。
Jevは、そもそも自由な文章を書くためのAIではない。
会話や長い説明の代わりに、ソフトウェアがそのまま利用できる小さな判断を返すモデルです。
「どの選択肢か」 「どの程度か」 「Yesである可能性はどれくらいか」
文章を生成するAIに加えて、判断を返すAIを使う。「全社員にChatGPT」の先を考えるなら、この使い方にも目を向けたいと思いました。
「それらしいことを、もっともらしく」
私はこれまで、「それらしいことを、もっともらしく」というLLMの厄介な性質に、何度も翻弄されてきました。
間違いそのものより、正しそうに見えることが厄介です。文章は自然で、理由まで付いている。「説明に納得できる」ことと「内容が正しい」ことを、つい重ねて読んでしまう。
だから、Jevの「自由な文章が必要ない仕事なら、最初から自由な文章を生成させない」という発想が気になりました。
返すものを小さな判断に絞ったら、業務への組み込み方はどう変わるのか。私が考えたくなったのは、そこです。
Jevは何をしているのか
TypeSafe AIは、Jevを同社初の「System One Model」と位置付けています。名前の由来は、『Thinking, Fast and Slow』で知られるSystem 1、つまり速く直感的な判断です。
Jevへ渡すのは、判断対象となる情報「state」と、それに対する質問です。
例えば、顧客からこんな問い合わせが届いたとします。
商品サイズが違うし、二重請求もされています。
ここで「全部考えて対応してください」と丸ごと頼むのではなく、判断を分けます。
- 返品に関する用件があるか。
- 請求に関する用件があるか。
- 顧客の不満度はどの程度か。
- 緊急性は高いか。
TypeSafeは、こうした判断を3種類の基本部品、プリミティブとして提供しています。
- Choice:候補から選ぶ。 定義された選択肢から選び、候補ごとの確率分布とconfidenceも返します。
- Score:尺度に沿って評価する。 説明を付けた段階に沿って評価し、スコア、段階ごとの確率分布、confidenceを返します。
- Noul:Yesの確率を返す。 Yes / No型の問いに対し、Yesであると予測する確率を0〜1で返します。別のconfidence値は付きません。
共通しているのは、自由文ではなく、あらかじめ定義された型の中で判断を返すことです。
その後の制御はコード側で書きます。返品に関する用件があれば返品窓口へ。請求にも問題があれば、その確認も開始する。条件を満たさなければ、追加情報の取得や人間の確認へ回す。
AIは曖昧な部分を判断し、その判断によって何が起きるかはソフトウェア側で決める。
AI自身が、次の処理を選び、実行し、結果を見てまた考える司令塔であり続ける必要はありません。
構造化出力そのものは、新しくない
ここまで読むと、「それなら既存のLLMでもできるのでは」と思うかもしれません。実際、JSONや決められた選択肢で回答させることは、Jev以前からできます。
OpenAIのStructured OutputsやvLLMには、出力を形式や選択肢に合わせて制約する仕組みがあります。DSPyにも、LLMへの入出力を型付きで定義し、プログラムとして構成する考え方があります。分類器そのものなら、さらに昔から存在します。
汎用LLMのトークンの確率情報、logprobsを分類に使う方法もあります。ただし、トークンの確率と、業務上の選択肢について信頼できる確率は別です。
Jevで注目したいのは、型付きの判断を返すことを、モデルの中心的な仕事として前面に出したことです。自由度を狭め、構造化された判断、確率出力、並列処理、速度、コスト効率を重視しています。
言ってしまえば、「大量の曖昧なif文を処理するためのAI」として見ると、狙いが分かりやすい。
自由度は能力でもありますが、本番システムでは統治コストにもなります。何を許し、何を検証し、どこで止めるのかを決める必要があるからです。
一方、十分な教師データがあり、問題が安定しているなら、従来型の専用分類器が適切な場合もあります。条件が明確なら、コードで十分です。
「hallucinationしない」は、一度分解して読む
TypeSafeは発表記事で、Jevについて「can’t hallucinate」と強く表現しています。ここは、そのまま「間違えない」と受け取れないところです。
例えば、出力できる部署がbilling、returns、shippingの3種類なら、候補にないlegal_departmentという部署名を勝手に作る失敗は防げます。
しかし、本当はreturnsへ送るべき問い合わせをbillingと判断する可能性は残ります。
「定義した候補の範囲を外れない」ことと、「正しい答えを選ぶ」ことは別です。
私には、型が完全に守られるからこその怖さもあるように見えます。意味上の誤りが、きれいな形のまま静かにシステムを通過することです。
部署名は正しい。データ型も正しい。処理も正常に進む。それでも、送る先が間違っている。
では、confidenceを見ればよいのでしょうか。
公式のConfidence解説によると、ChoiceやScoreのconfidenceは、確率分布の形を0〜1にまとめた指標です。一つの候補へ集中していれば高く、分散していれば低くなる。外部から正しさを確認した数字ではありません。間違った選択肢へ集中すれば、高いconfidenceで間違うこともあります。
また、Noulの0.1は「自信がない」ではなく、「Yesであると予測する確率が低い」という意味です。
TypeSafeはconfidenceに応じた自動処理や人間への引き継ぎを示していますが、型、確率、判断の正しさ、実行の可否は、分けて考える必要があります。
AI判断を本番利用する前に、4つの観点で確認する
企業がAIの判断を利用するとき、私は少なくとも次の4つを分けて考えています。
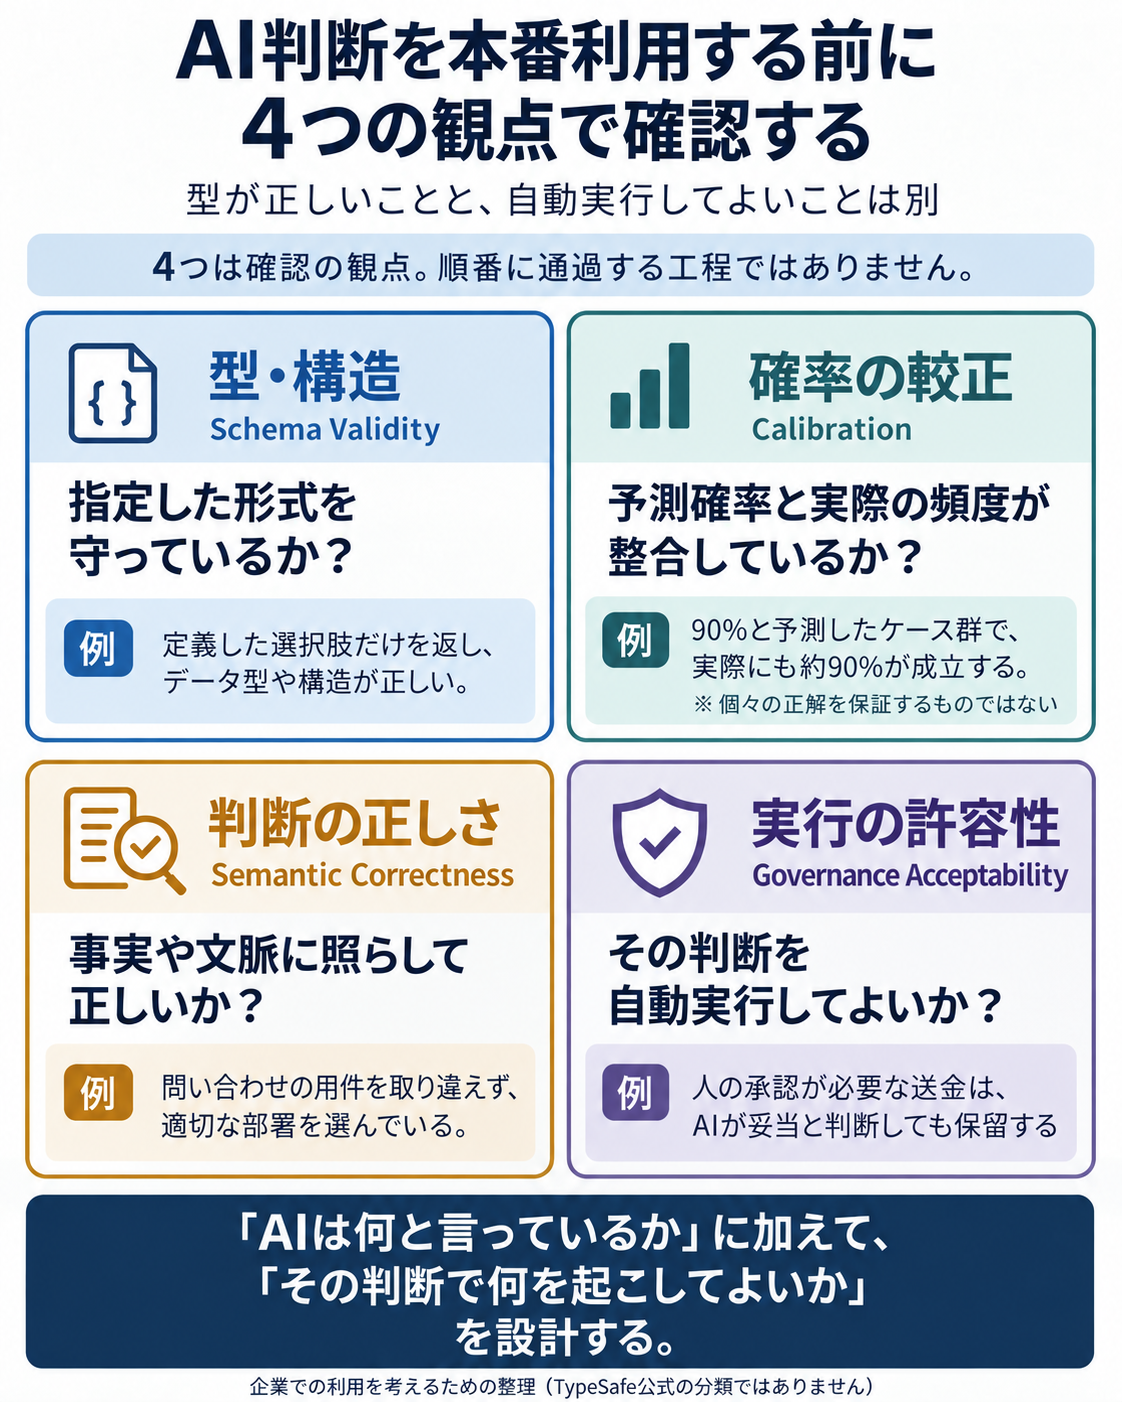
※TypeSafe公式の分類ではなく、私が企業での利用を考えるために分けた観点です。順番に通過すればよい直列工程ではありません。
型・構造が正しいか ― Schema Validity
指定された選択肢、形式、データ型を守り、ソフトウェアが想定した形式で受け取れるか。
予測確率は実際の頻度と整合しているか ― Calibration
ある事象が成立する確率を0.9と予測したケースを多数集めたとき、実際にもおおむね90%で成立しているか。
これは予測の集合について確認する「較正」という性質です。個々の回答の正しさを保証するものでも、製品固有のconfidenceをそのまま正答確率として読む話でもありません。
判断内容は現実に照らして正しいか ― Semantic Correctness
問い合わせを取り違えていないか。必要な情報を見落としていないか。事実や文脈に照らして中身を確認します。
その判断を自動実行してよいか ― Governance Acceptability
権限、影響範囲、取り消しの可否、外部の証拠、人間の承認といった条件から、実行を許可するかを判断します。人の承認が必要な送金なら、AIが妥当と判断しても保留します。
実際の検証では、自社の対象業務に合わせ、情報不足や例外を含む評価用の事例を用意します。誰がどの根拠で正しさを評価するか、どの誤りをどこまで許容し、どの条件で保留・停止するかを定めます。
検証件数や閾値は一律ではありません。誤判定の影響と求める確かさに応じて設計します。
冒頭の問い合わせなら、どう扱うでしょうか。
商品サイズが違うし、二重請求もされています。
以下は、Jevの実測に基づかない架空の設計例です。返品窓口では交換相談も扱い、返金には請求記録の照合と担当者の承認が必要、という業務ルールを仮定します。
| 判断・処理 | AIが返す結果の例 | コード側の条件と動作 |
|---|---|---|
| サイズ違い・返品交換に関する用件があるか | NoulのYes確率が、検証で定めた振り分け用の閾値以上 | 返品窓口への確認タスクを作る |
| 請求に関する用件があるか | NoulのYes確率が、検証で定めた振り分け用の閾値以上 | 同じ問い合わせにひも付けて、請求窓口への確認タスクも作る |
| 二重請求として返金してよいか | ―(返金可否は、この分類では判定しない) | 請求記録の照合と承認が揃うまで、返金処理を保留する |
ここでは、問い合わせを一つの部署へ押し込めず、二つの用件を拾っています。一方、「二重請求と書かれている」ことを「実際に二重請求があった」こととして扱ってはいません。
この例で、所定の型で結果を受け取れるかを見るのが型・構造の確認です。二つの用件を適切に拾えたかを見るのが判断内容の確認。確率の較正は、この一件ではなく同種の事例を集めて確かめます。そして、振り分けは進めても返金は保留する、という条件が実行の許容性に当たります。
AIの判断が処理を動かすきっかけになっても、すべての実行権限を与える必要はありません。
私が4つの観点を分けたいのは、この違いを設計に残したいからです。
Prompt Engineeringに加えて、判断境界の設計へ
例えば、不正取引について「この取引は不正か?」と一つだけ聞くこともできます。しかし、
- 本人情報に不整合があるか。
- 普段と違う場所から操作されているか。
- 金額が通常のパターンから逸脱しているか。
と分けた方が、業務ルールと結び付けやすいかもしれません。
何を聞くかと同じくらい、何を「答えとして許すか」も重要です。
「承認」と「拒否」だけなら、情報不足の案件もどちらかへ押し込まれかねません。「判断不能」を設けるのか。別の条件で保留するのか。複数の用件があるのに、一つだけ選ばせていないか。
質問形式にも注意が要ります。
公式のJev 1.13の制約ページには、顧客が返金を求めているかという同じ問いを、NoulとYes / NoのChoiceで尋ねた例があります。その事例では、Noulは0.22、ChoiceのYesの確率は0.01でした。
特定の例であり、一般的な誤差の大きさを示す数字ではありません。ただ、「同じ意味の質問だから、同じ確率として扱える」とは限らないことを示しています。公式も、Noulで調整した閾値をChoiceへそのまま移さないよう説明しています。
選択肢や尺度だけでなく、質問形式と閾値の組み合わせも、検証すべき設計の一部になります。
私はこれを、Prompt Engineeringに加えて、Decision Boundary Engineering――判断境界を設計する仕事として捉えたいと思っています。
ここでいう判断境界は、機械学習でいうクラス間の「決定境界」ではありません。問い、選択肢、閾値、保留条件、実行権限を含め、業務上どこまで判断し、何を起こしてよいかを定める境界です。
判断を小さく分ければ、入力と出力を記録して評価し、モデルやルールを交換しやすくなります。ただ、文脈の欠落や組み合わせの誤りも起こり得るため、部品ごとと業務全体の両方で評価します。
本当に効いているのは「モデル」か、「問題の分解」か
TypeSafeの業務フロー評価「Workflow Evals」には、Jevの性能とは別に気になる点があります。
比較対象の生成LLMでも、同じ業務方針を一つのプロンプトで処理させるより、判断を分解したワークフローを使う方が、評価上の一致度、コスト、処理時間で改善が見られたと報告されていることです。
改善には、モデルの違いだけでなく、問題の分解やワークフロー構成も寄与している可能性があります。
ただし、公式の評価方法の説明によると、この評価は業務を表現したコードが正しいと仮定し、高性能な外部モデル群の予測を平均して参照値を作っています。現実の業務結果を人間が確認した正解データ、Ground Truthそのものではありません。
TypeSafe自身も、自社チームがワークフローを作ったことによるバイアスの可能性や、速度・コスト改善が実利用では上限寄りになり得ることを説明しています。
第三者の試用では、EveryのMike Taylor氏が文章に関する多数の判定を非常に短時間で処理できたと報告する一方、精度の厳密な確認は今後の課題としています。TypeSafeが説明する訓練手法の優位性や外部での再現性も、今回確認した公開資料だけでは判断できません。
それでも、モデルを替える前に、問題の渡し方を見直す余地はありそうです。これはJevの導入にかかわらず、自社で試せる話です。
最大性能ではなく、「必要十分」
企業が業務の途中で欲しいのは、いつも会話や美しい文章とは限りません。
「この問い合わせをどこへ送るか」 「この申請は人間の確認が必要か」 「この設備ログは追加調査の対象か」
こうした場面では、manual_review = trueやroute = "support_B"といった、次の処理へ渡せる結果が役に立ちます。
人間が使うAIと、システムが使うAIでは、必要なインターフェースが違うのです。
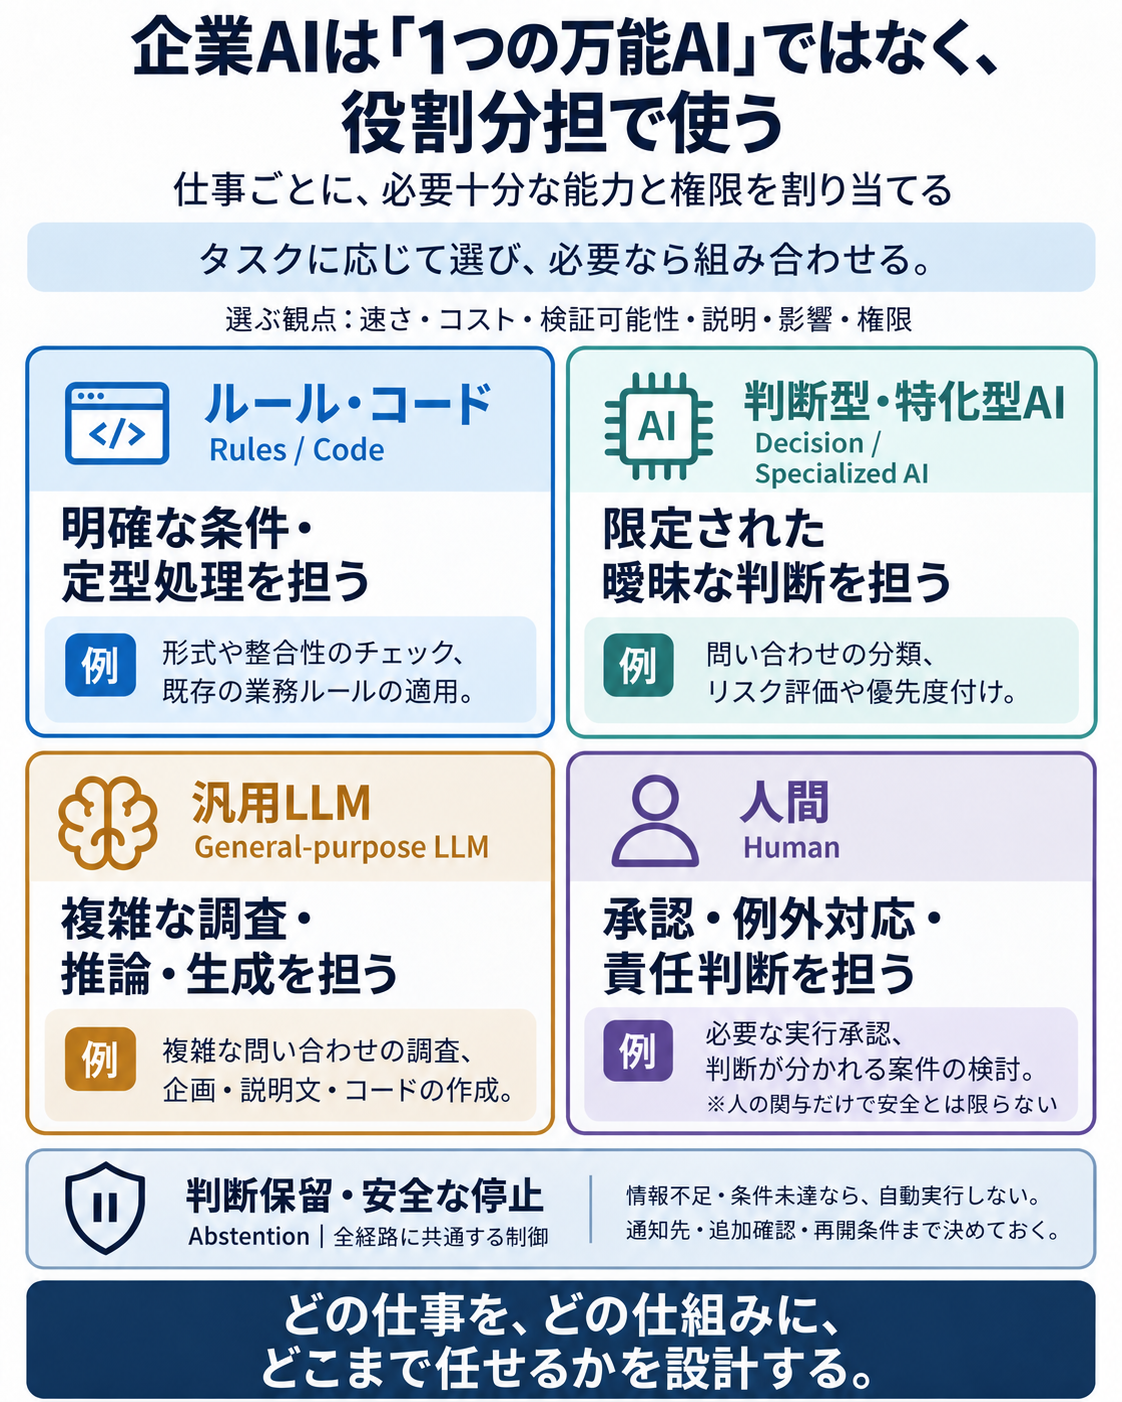
明確な条件ならコード。限定された曖昧な判断なら判断型・特化型AI。複雑な調査や推論、文章生成なら汎用LLM。承認や責任を伴う場面では人間の関与を設ける。
人間にも、判断に必要な情報と、実行を止められる権限が必要です。
公式はJev 1.13について、計数や数値処理、日付比較、複数段階の参照、無関係な情報の多い入力などを弱点として挙げています。計算や日付の比較はコードに任せるという説明もあります。
その処理を得意な仕組みに渡す。モデルの得意不得意を読むと、役割分担は具体的になります。
なお、ここでいう「特化」は、特定業務の専用モデルに限らず、Jevのように型付きの判断を返すという仕事の形を重視するモデルも含みます。
図のAbstention――判断保留や安全な停止――は、5種類目の処理主体ではなく、全経路に共通する制御上の選択肢です。保留するなら、通知先、追加確認、再開条件まで決めておきます。
速さ、コスト、検証可能性、必要な説明、誤ったときの影響を見て、その仕事に必要な能力と権限を割り当てます。
Jevonsの名前が示す、もう一つの変化
TypeSafeによれば、Jevという名前は経済学者William Stanley Jevonsに由来します。
効率化によって利用が広がり、総消費が増えることがあるという「ジェボンズのパラドックス」を、AI判断のコスト低下に重ねているわけです。
AI判断が仮に100倍安くなっても、企業のAI利用コストが100分の1になるとは限りません。これまで呼ばなかった場所でも使えるようになるからです。大量の小さな判断が、業務全体として何を起こしているかを見る必要も出てきます。
ただ、私が気になるのは、安さのもう一つの使い方です。
AIへ任せる範囲を広げるだけでなく、確認する回数を増やすことです。
入力を受け取ったとき。検索結果を得たあと。エージェントがツールを実行する前。データを書き換える前。外部へ送信する前。
コストや速度の制約で置きにくかった確認処理を、途中に挟めるかもしれません。
ここには注意点もあります。公式はJev 1.13について、入力データに含まれる敵対的な指示や意図的な誘導によって、回答が変わる可能性を説明しています。
チェックするAI自身も、チェック対象の影響を受け得る。同じ見落としを共有する判断器を重ねても、独立した確認にはなりません。
明確な権限や実行条件はコードなどで制約し、AIのチェックが何を検出でき、どのような入力で失敗するかを評価する。その前提で経済的に成立するなら、コスト低下は安全性や品質管理の設計も変える可能性があります。
安さは、AIに任せる量を増やす力にも、AIを確かめる量を増やす力にもなる。
「何人がChatGPTを使ったか」だけで測らない
社員のAI利用率や週次アクティブユーザー数を見ることには意味があります。ただ、AIがソフトウェア内部へ入っていくなら、私なら次の問いも置きたいです。
「自社の業務判断のうち、どこまでが安全に機械実行可能になったか?」
ここで見たいのは、単なる自動化率ではありません。判断不能なら保留できるか。誤りを検出し、影響を抑え、復旧できるか。なぜその判断をその仕組みに任せたのかを説明できるか。
件数や割合だけでは、簡単な判断を大量に自動化するほど良い数字に見えてしまいます。業務の影響の大きさを区別し、誤実行や差し戻しも併せて見ます。
本番利用前には、業務データの外部送信の可否、利用条件、データの保存・取り扱いを確認する。導入後は、確認済みの事例を蓄積し、入力や業務の変化によって判断の質が落ちていないかを見続ける。
この確認にも費用はかかります。人手で参照となる判断を作るなら、影響の大きい業務から評価するなど、確認の範囲も設計する必要があります。
社員がAIを使っていると意識しない場所にも、小さな判断が組み込まれ、その実行条件と責任の境界が設計されている。そんな企業も、十分に「AI活用が進んだ企業」と呼べるはずです。
AIは「会話相手」に加えて、「計算部品」になる
Jevが前面に出しているのは、型付きの判断や確率をソフトウェアへ渡す方向です。私なりに整理すれば、Software + Agentに加えて、Software + Intelligence Primitive――ソフトウェアと知能部品を組み合わせる設計です。
ここでいう「計算部品」は、正確な算術ではなく、ソフトウェアから呼び出して限定された判断を受け取る部品という意味です。
AIをソフトウェア部品として使うこと自体は以前から行われています。私がJevを通じて価値を感じているのは、判断を返すAIと、実行を制御するソフトウェアの役割を明確にする方向性です。
Jevという製品の適合性は、判断の質、失敗の仕方、運用条件を含めて見極める必要があります。それでも、今回の発表は、企業AIの設計を考え直すきっかけになります。
「全社員にChatGPT」は、社員の知的作業を支える選択肢です。それに加えて、社員がチャット画面を開かなくても進む業務を、どう設計するか。
どの仕事を、どの仕組みに、どこまで任せるか。そして、その判断によって何が起きてよいか。
今回の発表を読んで、私の関心は、Jevの速さや価格から、自社ならこの境界をどこに置くかへ移りました。
参考情報
一次情報
- TypeSafe AI:Introducing System One Models & Jev
- TypeSafe AI:Developer Documentation
- TypeSafe AI:Confidence
- TypeSafe AI:AI Primer
- TypeSafe AI:Choice
- TypeSafe AI:Score
- TypeSafe AI:Noul
- TypeSafe AI:Workflow Evals
- TypeSafe AI:Jev 1.13 jaggedness
比較・概念の参考資料
- OpenAI:Introducing Structured Outputs in the API
- vLLM:Structured Outputs
- DSPy:Signatures in Depth
- Chuan Guo, Geoff Pleiss, Yu Sun, Kilian Q. Weinberger:On Calibration of Modern Neural Networks, Proceedings of ICML 2017
第三者による試用
- Mike Taylor / Every:Mini-Vibe Check: TypeSafe’s Jev Judged Everything I’ve Written in 0.7 Seconds
※本稿は2026年9月17日時点の公開情報を基に、9月24日に公式の制約情報などを確認・補足しています。
※JevはEarly Accessとして公開されており、速度、コスト、性能、CalibrationなどにはTypeSafe自身による評価・主張が含まれます。本文では、ベンダーの説明、評価方法から確認できること、第三者の試用、私自身の考察を区別しています。
