
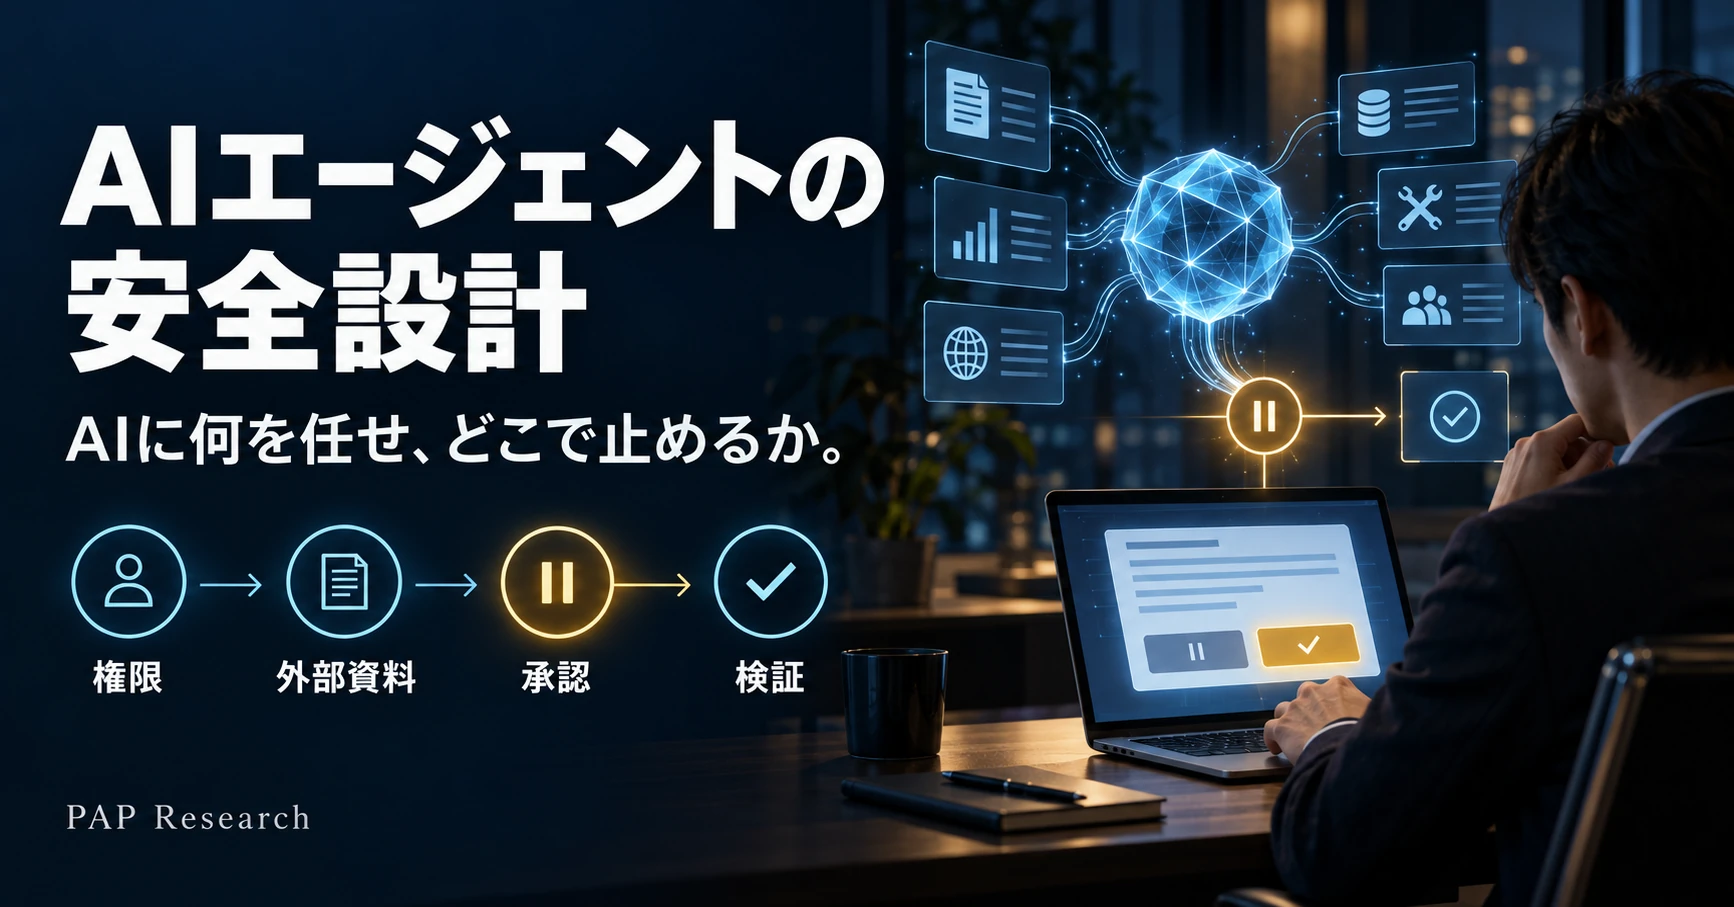
AIに何を任せ、どこで止めるか。
AIエージェントは、文章を作るだけでなく、ツールやAPIを使ってデータを読み、送信や更新まで行えるAIです。任せられる作業が増えるほど、「プロンプトで丁寧に頼む」だけでは安全は決まりません。どの範囲を任せ、外部の資料をどう扱い、送信や変更をどこで止め、その仕組みが働くことをどう確かめるかを、順番に決める必要があります。
このページでは、PAP Researchの解説記事を、設計で決める順に並べました。各段階で「何を決めるか」を短く説明し、詳しい手順は個別の記事へ案内します。
このページで分かること:AIに任せる範囲と権限の決め方、外部資料に書かれた命令への備え、送信・変更の制御と人間承認の分担、安全対策が働くかの確かめ方。
AIを使う前の安全確認を習慣にする考え方は、AIKY(AI利用における危険予知)で説明しています。
決める順番の早見表
| 段階 | 決めること | 最初に読む記事 |
|---|---|---|
| 1.任せる範囲 | 対象・操作・利用者を決め、必要な権限だけを渡す | AIの適用範囲と権限は、対象・操作・利用者で決める |
| 2.外部資料の扱い | 命令として従う情報と、内容として読むだけのデータの境目 | 命令階層と信頼境界とは? AIへの指示と外部資料を分ける基本 |
| 3.送信・変更の制御 | プロンプト・システムによる強制・人間承認の役割分担 | AIの送信をどう制御する? 指示・システムの強制・人間承認の役割 |
| 4.動作の確認 | 許可・拒否・保留が想定どおりに働くか | AIへ仕事を任せる前のチェックリスト――確認資料と止める条件まで決める |
1.AIにどこまで任せるか――適用範囲と権限
最初に決めるのは、AIが扱う対象、行ってよい操作、誰の依頼として動くかです。「この仕事だけをして」とプロンプトに書くことと、システムがその範囲しか実行できないことは別です。範囲外の操作は、AIが断るだけでなく、アプリやAPIの側でも拒否されるようにします。
外部APIを使う場合は、仕事に必要な操作を先に列挙し、それに合う権限だけを接続します。OWASP Top 10 for LLM Applications 2025は、LLMを使うシステムに与えた機能・権限・自律性が過剰なことによるリスクを「Excessive Agency」(LLM06)として挙げています。
- 範囲の決め方:AIの適用範囲と権限は、対象・操作・利用者で決める
- API連携の権限:外部APIを使うAIには、操作・対象・期限を絞った権限を渡す
- 業務ごとのリスクの見方:AIの用途別リスク分類は、業務への影響から統制を選ぶ/AIの確認をどこまで厳しくする? 同じ作業でも変わるリスクの見方
- 用語:最小権限
2.外部資料の命令に従わせない――信頼境界とプロンプトインジェクション
AIエージェントは、Webページ、メール、文書、ツールの返却値など、外部の情報を読み込みながら作業します。その中に「この内容を転送せよ」のような文が含まれていても、それは作業の材料であって、従うべき指示ではありません。命令として扱う情報と、内容として読むだけのデータの境目(信頼境界)を、設計の段階で決めておきます。
外部の資料などに紛れ込ませた文でAIに意図しない動作をさせる攻撃はプロンプトインジェクションと呼ばれ、OWASP Top 10 for LLM Applications 2025の最初の項目(LLM01)です。区切り記号やXMLタグで資料を分けることは役に立ちますが、それだけで資料内の命令を無効にはできません。資料から許可のない操作が起きないよう、権限と実行側の制御を組み合わせます。
- 基本の考え方:命令階層と信頼境界とは? AIへの指示と外部資料を分ける基本
- 指示と資料の分け方:指示・参考資料・ユーザー入力を区切り記号で分離する/XMLタグで命令とデータを分ける方法と、タグだけでは守れない境界
- ツールや他のAIからの入力:MCPのツール説明はどこまで信頼できる? 機能の説明と実行権限を分ける/AI出力を別のエージェントへ渡すとき、生成文で権限を広げない設計
- 入口と経路の洗い出し:LLMアプリの何を守る? 資産・入口・信頼境界を洗い出す手順/AIの脅威モデリングとは? データからツールへ届く経路を点検する
- 用語:信頼境界/プロンプトインジェクション
3.送信や変更をどう管理するか――実行側の制御と人間承認
メールの送信、データの更新、機械の操作など、外部に影響が残る操作は、プロンプトでの指示、システムによる条件の検証、人による判断の三つに役割を分けます。AIが指示を守った割合が高くても、それは試した条件での結果であり、常に守る保証にはなりません。重大な操作は、指示が守られなかった場合でも実行側で止まる構成にします。
人間承認(Human-in-the-Loop)は、何でも人に確認させればよいという意味ではありません。拒否する操作、範囲を狭めて続ける操作、人の確認を待つ操作を分けておくと、低リスクの作業を止めすぎずに済みます。
- 役割の分け方:AIの送信をどう制御する? 指示・システムの強制・人間承認の役割
- 拒否・縮小・確認の使い分け:AIの安全統制(ガードレール)とは? 拒否・作業の縮小・人間確認を選ぶ基本
- 指示の遵守を保証にしない:プロンプト遵守を保証にしない――測定結果と実行制御を分ける
- 機械を動かす場合:AIが機械を動かすなら、非常停止と進入制限をAIの判断から分離する
- 用語:Human-in-the-Loop(HITL)
4.安全対策が働くかを確かめる――許可・拒否・保留の確認
設計した制限は、想定どおりに働くことを確かめて初めて意味を持ちます。許可された作業が通ることだけでなく、範囲外の要求が実行窓口で止まること、確認できない条件があるときに作業が保留されることを、別々の試験として計画します。
| 確認の種類 | 確かめること | 例(架空の問い合わせ対応AI) |
|---|---|---|
| 許可 | 許可された対象・操作だけが実行される | 担当チケットの状態を「対応中」に更新でき、何を更新したかが利用者に伝わる |
| 拒否 | 範囲外の要求が、AIの返答だけでなく実行側でも止まる | 担当外のチケットの更新や削除を求めても、APIの側で拒否される |
| 保留・停止 | 必要な確認ができないとき、作業が進まない | 認証の期限切れや応答不明のときは再送せず、状態を確かめてから人が再開を判断する |
確認の結果は、どの対策を、どの用途に、なぜ適用したかとあわせて記録しておくと、モデルや業務が変わったときに見直しやすくなります。
AIの回答は変わる前提で設計する
同じ質問でも、AIの答えは時期や条件によって変わることがあります。PAP Researchの定点観測でも、時刻・最新情報・モデル名の答え方などに変化が記録されています。安全対策をプロンプトとAIの判断だけに頼らず、権限と実行側の制御で支えるのはこのためです。観測の整理は「ChatGPTの回答が変わるのはなぜ? 定点観測で分かった変化と、言えないこと」をご覧ください。
設計用語を詳しく確認する:ガードレール、Fail ClosedとFail Openの違い、自動化バイアスと人間の確認。
作業の前に確かめる12項目は、「AIを使う前の安全確認チェックリスト」に1枚の表でまとめています。社内資料にも使えます。
公式資料
- OWASP Top 10 for LLM Applications 2025(LLM01: Prompt Injection、LLM06: Excessive Agency)
- OWASP Authorization Cheat Sheet(最小権限、初期状態での拒否、要求ごとの権限確認)
問い合わせ対応AIは説明用の架空の設計例です。「模擬APIで確かめた権限制御」は、条件を限定して実際に行った検証です。実際の設計では、利用するサービスの仕様と、組織の規程・法令を確認してください。
辞典で関連分野を調べる
安全設計に関わる用語を、AI・LLM実務辞典の分野別ページでまとめて確認できます。
- データ・プライバシー・情報管理:AIに渡す情報の区分と、個人情報・機密情報の管理に関わる用語
- 日本実務・業務運用・法務・経理リスク:日本の業務でAIを使うときの実務・法務・経理のリスク用語
- Observability・AI-SRE・インシデント:稼働状況の把握と障害対応に関わる用語
- Provenance・真正性・Open Weight・モデル供給形態:コンテンツやモデルの出所・真正性に関わる用語